SUNO WAR NUR DER ANFANG
Sony und Warner nehmen Claude ins Visier, und der Copyright-Krieg um KI erreicht die nächste Stufe
Text: WILD Redaktion ·
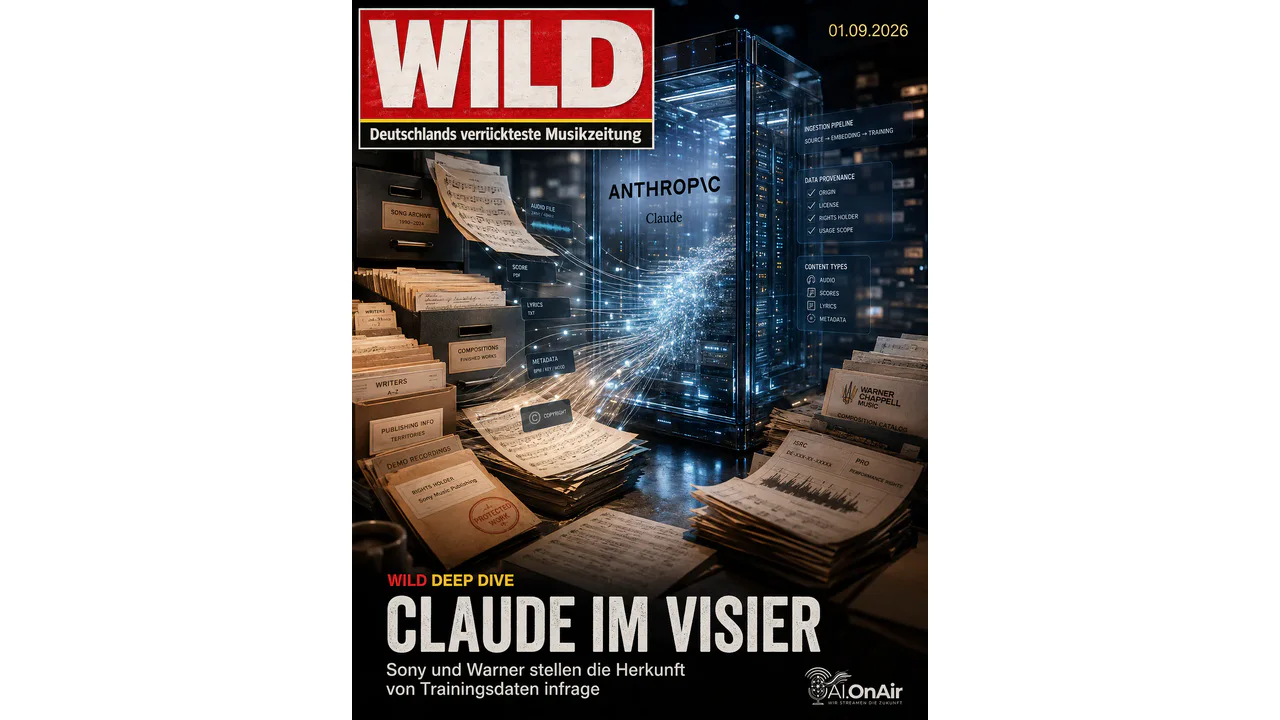
Der Konflikt zwischen Musikindustrie und künstlicher Intelligenz erreicht eine neue Dimension. Sony Music Publishing, Warner Chappell und weitere Musikverlage verklagen Anthropic und stellen damit nicht nur die Nutzung geschützter Werke beim KI-Training infrage, sondern auch die Herkunft der dafür verwendeten Daten. Der Fall könnte weit über Claude hinaus Bedeutung für die gesamte generative KI-Branche entwickeln.
Lange sah es so aus, als würde sich der große Konflikt zwischen Musikindustrie und künstlicher Intelligenz vor allem an Unternehmen wie Suno und Udio entzünden. Dort liegt die Verbindung auf der Hand: Musik hinein, Musik heraus, dazwischen ein Modell, über dessen Trainingsmaterial seit Jahren gestritten wird. Doch seit Ende August verschiebt sich diese Front erheblich.
Am 28. August 2026 reichten Sony Music Publishing, Warner Chappell Music und zahlreiche verbundene Musikverlage beim US District Court for the Northern District of California Klage gegen Anthropic ein. Mitverklagt werden Anthropic-CEO und Mitgründer Dario Amodei sowie Mitgründer Benjamin Mann persönlich. Der Vorwurf lautet, für die Entwicklung der Claude-Modelle seien in großem Umfang urheberrechtlich geschützte musikalische Werke ohne Erlaubnis beschafft, kopiert und verwendet worden.
Damit geht es plötzlich nicht mehr nur um die Frage, wie eine KI Musik erzeugt. Im Mittelpunkt steht nun auch die Frage, welche Rolle Musik, Songtexte und Noten grundsätzlich beim Aufbau großer generativer KI-Systeme gespielt haben könnten.
🟨 NICHT SUNO. NICHT UDIO. CLAUDE.
Genau hier liegt die Bedeutung dieses Verfahrens. Claude ist kein Dienst, dessen Kernprodukt darin besteht, aus einem Prompt einen fertigen Song zu generieren. Anthropic gehört zu den großen Entwicklern allgemeiner Sprachmodelle. Claude schreibt Texte, analysiert Dokumente, programmiert Software und beantwortet Fragen.
Wenn Musikverlage nun behaupten, dass auch ein solches System mit massenhaft geschützten musikalischen Werken trainiert worden sei, wird aus einem Spezialproblem der KI-Musikbranche ein grundsätzliches Problem generativer KI. Die Kläger sprechen von Zehntausenden geschützten Kompositionen.
In Berichten über die Klage werden Werke aus Katalogen genannt, die mit Künstlern und Songwritern wie Taylor Swift, Marvin Gaye, Mariah Carey oder Bon Jovi verbunden sind. Entscheidend ist dabei jedoch weniger die Prominenz einzelner Titel als die behauptete Größenordnung.
🟨 ES GEHT NICHT UM DIE ORIGINALAUFNAHMEN
Wer bei Sony und Warner sofort an Spotify-Aufnahmen, Masterrechte und komplette Audiodateien denkt, landet bei diesem Verfahren an der falschen Stelle. Im Mittelpunkt stehen musikalische Kompositionen.
Eine Musikaufnahme und die ihr zugrunde liegende Komposition sind urheberrechtlich unterschiedliche Dinge. Eine Aufnahme kann einem Label gehören oder von ihm kontrolliert werden. Text, Melodie und die eigentliche Komposition können dagegen bei Songwritern und Musikverlagen liegen.
Sony Music Publishing und Warner Chappell vertreten genau solche Rechte. Deshalb konzentriert sich die Klage unter anderem auf Songtexte, Noten und andere Darstellungen geschützter Kompositionen. Ein allgemeines Sprachmodell muss keine Audiodatei eines Songs besitzen, um mit dessen Text, Melodieinformationen oder notierter Komposition in Berührung gekommen zu sein.
🟨 DER EXPLOSIVSTE VORWURF LIEGT VOR DEM TRAINING
Beim Thema künstliche Intelligenz wird häufig sofort über Fair Use diskutiert. Darf ein Modell ein urheberrechtlich geschütztes Werk analysieren, um daraus statistische Zusammenhänge zu lernen? Ist dieser Vorgang transformativ, und entsteht dadurch eine rechtlich relevante Konkurrenz zum Original?
Die neue Klage versucht allerdings, noch einen Schritt vorher anzusetzen. Sony Music Publishing, Warner Chappell und die weiteren Kläger behaupten, Anthropic habe Material unter anderem durch Downloads aus nicht autorisierten Quellen, Scraping und weitere Methoden beschafft. Berichte über die Klageschrift nennen dabei auch sogenannte Shadow Libraries und umfangreiche Sammlungen digitalisierter Werke.
Anthropic bestreitet die Vorwürfe und will sich vor Gericht dagegen verteidigen. Genau an dieser Stelle bekommt der Fall eine Vorgeschichte, die für das Unternehmen besonders relevant werden könnte.
🟨 EIN GERICHT HAT DIESE GRENZE BEREITS EINMAL GEZOGEN
Anthropic hat einen der wichtigsten bisherigen Prozesse zum Thema KI-Training bereits hinter sich. Im Verfahren „Bartz v. Anthropic“ ging es um Bücher, die für die Entwicklung von Claude verwendet worden waren.
Die Entscheidung fiel keineswegs so simpel aus wie „KI-Training ist erlaubt“ oder „KI-Training ist verboten“. Das Gericht unterschied zwischen verschiedenen Handlungen und der Herkunft des verwendeten Materials.
Die Verwendung rechtmäßig beschaffter Bücher zum Training eines Sprachmodells wurde in dem Verfahren in wesentlichen Punkten als Fair Use angesehen. Bei massenhaft aus Piratenbibliotheken heruntergeladenen Büchern zog das Gericht dagegen eine andere Grenze.
Genau diese Trennung könnte im neuen Musikverfahren zu einem zentralen Punkt werden. Selbst wenn Anthropic erfolgreich argumentieren könnte, dass das eigentliche Lernen eines Modells aus geschützten Werken unter bestimmten Umständen Fair Use darstellt, beantwortet das noch nicht die Frage, wie die dafür verwendeten Kopien beschafft wurden.
Ein Gericht könnte theoretisch zu dem Ergebnis kommen, dass ein bestimmter Lernprozess zulässig war, die Beschaffung des Lernmaterials aber trotzdem rechtswidrig. Das ist ein entscheidender Unterschied.
🟨 1,5 MILLIARDEN DOLLAR HÄNGEN BEREITS ÜBER DER DEBATTE
Die Brisanz wird noch größer, weil die Auseinandersetzung um die Bücher längst finanzielle Folgen hatte. Im entsprechenden Autorenverfahren wurde ein Vergleich über rund 1,5 Milliarden Dollar genehmigt. Er betrifft hunderttausende Bücher, die aus Piratenquellen stammen sollen.
Die Vorgeschichte zeigt, wie wichtig die Unterscheidung zwischen dem eigentlichen KI-Training und der Herkunft des Trainingsmaterials geworden ist. Für die Musikverlage ist diese juristische Linie besonders relevant.
Ihre neue Klage kommt deshalb nicht in ein rechtliches Vakuum. Sie trifft ein Unternehmen, bei dem Gerichte bereits sehr genau zwischen dem Zweck des Trainings und der Beschaffung des verwendeten Materials unterschieden haben.
Damit könnte der Kampf um Trainingsdaten in eine neue Phase eintreten. Bisher lautete die große öffentliche Frage häufig: „Darf eine KI aus geschützten Werken lernen?“ Die nächste könnte lauten: „Woher hatte die KI diese Werke überhaupt?“
🟨 CLAUDE UND SONGTEXTE SIND SCHON LÄNGER EIN THEMA
Völlig neu ist Anthropic im Musikurheberrecht nicht. Bereits seit Jahren läuft ein weiteres Verfahren von Musikverlagen gegen das Unternehmen.
Concord Music Group, Universal Music Publishing Group und weitere Rechteinhaber warfen Anthropic unter anderem vor, geschützte Songtexte für Claude verwendet zu haben und dass Modelle Teile solcher Texte ausgeben könnten.
Im Januar 2025 einigten sich die Parteien auf bestimmte Schutzmaßnahmen. Anthropic verpflichtete sich dabei, bestehende technische Schutzmechanismen gegen die Ausgabe geschützter Lyrics beizubehalten und entsprechende Maßnahmen auch bei zukünftigen Modellen einzusetzen.
Eine später beantragte einstweilige Verfügung gegen die Verwendung von Lyrics beim Training wurde vom Gericht im März 2025 allerdings abgelehnt. Das war kein endgültiges Urteil darüber, ob sämtliche Trainingspraktiken von Anthropic rechtmäßig waren, sondern eine Entscheidung darüber, ob die Voraussetzungen für eine vorläufige gerichtliche Maßnahme erfüllt waren.
Damit existieren mehrere Ebenen gleichzeitig: Was darf in ein Modell hinein? Was darf aus ihm herauskommen? Wie wurde das Material beschafft? Und welche technischen Maßnahmen muss ein Anbieter einsetzen, damit geschützte Inhalte nicht einfach reproduziert werden können?
🟨 WENN CLAUDE EINEN SONGTEXT AUSGEBEN KANN
Die Kläger greifen nicht ausschließlich die Trainingsseite an. Sie behaupten auch, Claude könne geschützte Inhalte teilweise reproduzieren beziehungsweise Ausgaben erzeugen, die auf dem verwendeten Material beruhen.
Das berührt ein anderes Problem als die reine Trainingsfrage. Selbst wenn ein Gericht das Lernen aus einem Werk als transformativ akzeptiert, bedeutet das nicht automatisch, dass ein Modell anschließend größere geschützte Teile dieses Werkes an Nutzer ausgeben darf.
Deshalb investieren Anbieter generativer KI seit Jahren in Filter und andere Schutzmechanismen, die solche Ausgaben verhindern sollen. Die Grenze zwischen Lernen und Wiedergeben wird damit juristisch entscheidend.
Ein Mensch darf unzählige Songs hören und daraus etwas über Songwriting lernen. Er darf deshalb trotzdem nicht einfach einen vollständigen geschützten Songtext kopieren und als eigenen veröffentlichen. Die KI-Debatte versucht nun unter anderem zu klären, wie weit sich bekannte urheberrechtliche Prinzipien auf generative Modelle übertragen lassen.
🟨 WARUM AMODEI UND MANN PERSÖNLICH IN DER KLAGE STEHEN
Auffällig ist zudem, dass die Kläger nicht nur Anthropic als Unternehmen verklagen. Auch CEO Dario Amodei und Mitgründer Benjamin Mann werden im offiziellen Gerichtsdocket als Beklagte geführt.
Damit versuchen die Kläger nicht lediglich technische Prozesse des Unternehmens zum Gegenstand des Verfahrens zu machen, sondern auch Verantwortlichkeiten innerhalb der Unternehmensführung feststellen zu lassen. Ob und in welchem Umfang daraus tatsächlich eine persönliche Haftung entstehen kann, ist völlig offen.
Gerade bei diesem Punkt ist eine saubere Trennung wichtig. Eine Klageschrift enthält die Darstellung und Vorwürfe der Kläger. Sie ist kein Urteil und beweist für sich genommen noch keine Rechtsverletzung.
🟨 WIE TEUER KÖNNTE DAS WERDEN?
Die Kläger verlangen unter anderem gesetzlichen Schadensersatz. Bei vorsätzlichen Urheberrechtsverletzungen kann dieser nach US-Recht bis zu 150.000 Dollar pro betroffenem Werk erreichen.
Zusätzlich stehen Forderungen im Zusammenhang mit sogenannten Copyright Management Information im Raum. Dabei geht es vereinfacht gesagt um Informationen, mit denen Werke und Rechteinhaber identifiziert werden können.
Bei einer Klage, die von Zehntausenden Werken spricht, entstehen auf dem Papier sehr schnell gewaltige Summen. Das bedeutet allerdings nicht, dass Anthropic automatisch Milliarden zahlen muss.
Die tatsächliche Höhe hängt davon ab, welche Werke überhaupt erfolgreich zum Gegenstand eines Anspruchs gemacht werden können, welche Handlungen ein Gericht als Rechtsverletzung bewertet, ob Vorsatz festgestellt wird und welche Beträge letztlich zugesprochen werden. Die enorme Dimension ergibt sich deshalb zunächst aus dem möglichen Umfang der Ansprüche, nicht aus einer bereits feststehenden Schadensersatzsumme.
🟨 ANTHROPIC WIDERSPRICHT
Anthropic weist den Kern der Vorwürfe zurück und will sich nach eigenen Angaben energisch vor Gericht verteidigen. Das Unternehmen vertritt im größeren Copyrightstreit seit längerem die Position, dass das Training generativer Modelle unter bestimmten Voraussetzungen Fair Use sein kann.
Diese Position ist keineswegs völlig aus der Luft gegriffen. Amerikanische Gerichte haben in einzelnen KI-Verfahren bereits Entscheidungen getroffen, nach denen bestimmte Formen des Trainings unter bestimmten Voraussetzungen als Fair Use bewertet werden können.
Daraus lässt sich jedoch keine allgemeine Regel ableiten, nach der jedes KI-Training automatisch rechtmäßig wäre. Gerichte beurteilen konkrete Fälle. Entscheidend können Datenquelle, Art der Nutzung, Zweck der Kopien, technische Verarbeitung und mögliche Auswirkungen auf bestehende Märkte sein.
Genau deshalb sind Verfahren wie dieses so wichtig. Sie setzen Stück für Stück die Grenzen eines Rechtsgebiets, dessen technische Realität wesentlich schneller gewachsen ist als seine Rechtsprechung.
🟨 SUNO WAR MÖGLICHERWEISE NUR DIE SICHTBARSTE FRONT
Für die Musikbranche verändert dieser Fall das Bild. Bei Suno und Udio ist die Frage nach dem Trainingsmaterial beinahe zwangsläufig mit Musik verbunden, weil diese Systeme komplette Songs erzeugen.
Claude zeigt etwas anderes. Musik kann Teil des Trainingsmaterials eines allgemeinen KI-Systems sein, obwohl dessen Hauptzweck überhaupt nicht das Generieren von Musik ist.
Damit wird die entscheidende Frage größer. Wenn Songtexte, Bücher, journalistische Texte, Bilder, Softwarecode und andere geschützte Werke in Trainingskorpora großer KI-Systeme eingeflossen sind, handelt es sich dann wirklich noch um viele voneinander getrennte Copyrightkonflikte?
Oder erleben wir gerade einen gigantischen Streit darüber, auf welchem Material die generative KI-Ära aufgebaut wurde und wer für dessen Verwendung bezahlt werden muss?
🟨 DER KAMPF VERSCHIEBT SICH ZUR DATENQUELLE
Die erste Phase der öffentlichen KI-Debatte konzentrierte sich stark auf das Ergebnis. Klingt ein Song wie ein bekannter Künstler? Sieht ein generiertes Bild aus wie das Werk eines Illustrators? Gibt ein Chatbot einen existierenden Songtext wieder?
Die zweite Phase führt tiefer hinein. Jetzt geht es zunehmend um Datenherkunft, Lizenzen und nachvollziehbare Trainingsketten.
Woher kam ein Werk? War es frei verfügbar, lizenziert, gekauft, gescraped oder aus einer nicht autorisierten Bibliothek heruntergeladen? Wurde eine Kopie dauerhaft gespeichert, wurden Informationen über Rechteinhaber entfernt, und lässt sich Jahre später überhaupt noch rekonstruieren, welche Datei in welchem Trainingsprozess verwendet wurde?
Für KI-Unternehmen könnte genau diese Nachweisbarkeit künftig mindestens so wichtig werden wie die Qualität ihrer Modelle.
🟨 WAS BEDEUTET DAS FÜR KI-MUSIKER?
Für jemanden, der heute mit generativer KI Musik produziert, ändert diese Klage zunächst nichts unmittelbar. Ein Nutzer von Claude wird nicht automatisch zum Urheberrechtsverletzer, weil Anthropic verklagt wird. Ebenso beweist eine Klage gegen einen Modellanbieter nicht, dass jedes Ergebnis dieses Modells rechtswidrig ist.
Trotzdem betrifft die Entwicklung die gesamte kreative KI-Landschaft. Je stärker Gerichte zwischen legal beschafftem Trainingsmaterial und nicht autorisierten Datenquellen unterscheiden, desto wichtiger werden Herkunft und Lizenzierung der Trainingsdaten für Anbieter.
Gleichzeitig dürfte der wirtschaftliche Druck steigen, Rechteinhaber direkt zu lizenzieren, statt sich ausschließlich auf Fair-Use-Argumente zu verlassen. Langfristig könnte daraus ein Markt entstehen, in dem nicht nur Rechenleistung und bessere Modelle Wettbewerbsvorteile sind, sondern auch sauber lizenzierte Daten.
🟨 DAS EIGENTLICHE MILLIARDENBUSINESS KÖNNTE ERST BEGINNEN
Damit bekommt der Konflikt eine zweite Ebene. Musikkataloge waren bisher vor allem wertvoll, weil Songs gestreamt, verkauft, synchronisiert, aufgeführt und lizenziert werden konnten. KI eröffnet möglicherweise eine zusätzliche wirtschaftliche Nutzung: Trainingslizenzen.
Sollten Gerichte Rechteinhabern in entscheidenden Punkten folgen, könnte das den Wert großer Kataloge noch einmal verändern. Statt nur Menschen, Plattformen und klassische Medienunternehmen für die Nutzung eines Werkes zahlen zu lassen, würden auch Entwickler generativer Modelle zu potenziellen Lizenzkunden.
Dann wäre der Copyrightkrieg nicht nur ein Kampf darum, KI einzuschränken. Er wäre ebenso ein Kampf darum, wer wirtschaftlich am Aufbau der nächsten technologischen Plattform beteiligt wird.