Ein Instrument, mehrere Identitäten: Innerhalb weniger Tage ist rund um den M-VAVE FM-1 eine ungewöhnlich produktive Firmware-Szene entstanden. Kostenlose Open-Source-Projekte und ein kommerzielles System ersetzen die Herstelleroberfläche und verändern Klangarchitektur, Sequencer und Arbeitsweise grundlegend. WILD LAB klärt, was die Alternativen tatsächlich leisten, warum der niedrige Preis die Entwicklung beschleunigt und wo beim Flashen reale Risiken beginnen.
Ein KI-Song, eine geklonte Stimme oder ein künstlich erzeugter Konzertmitschnitt: Auf YouTube zählt, was im fertigen Upload zu hören und zu sehen ist. Die Offenlegungspflicht besteht bereits seit 2024. Für Musiker lohnt sich ein genauer Blick auf die aktuellen Regeln, denn zwischen Produktionshilfe, synthetischer Musik und realistisch nachgebildeten Personen bestehen wichtige Unterschiede.
Suno hat am 1. Oktober 2026 Speech (Beta) veröffentlicht, ein KI-Modell, das gesprochene Sprache und dazugehörige Musik simultan in einem einzigen Track erzeugt. Laut Suno ist es das erste Audio-Modell, das beides in einem Durchgang verbindet. Die Beta ist auf Mobile und Web offen, Suno räumt aber ausdrücklich Schwächen ein.
Google hat am 23. September 2026 zwei neue Text-to-Speech-Modelle vorgestellt, die weit über einfache Stimmensynthese hinausgehen. Gemini 3.8 Flash TTS und Flash-Lite TTS ermöglichen es, Charakterstimmen per Sprachprompt zu erschaffen, eigene Stimmen zu replizieren und mehrsprachige Audioproduktionen mit feiner Kontrolle zu steuern. Was das für Musiker, Podcaster und Creator bedeutet, untersucht WILD LAB.
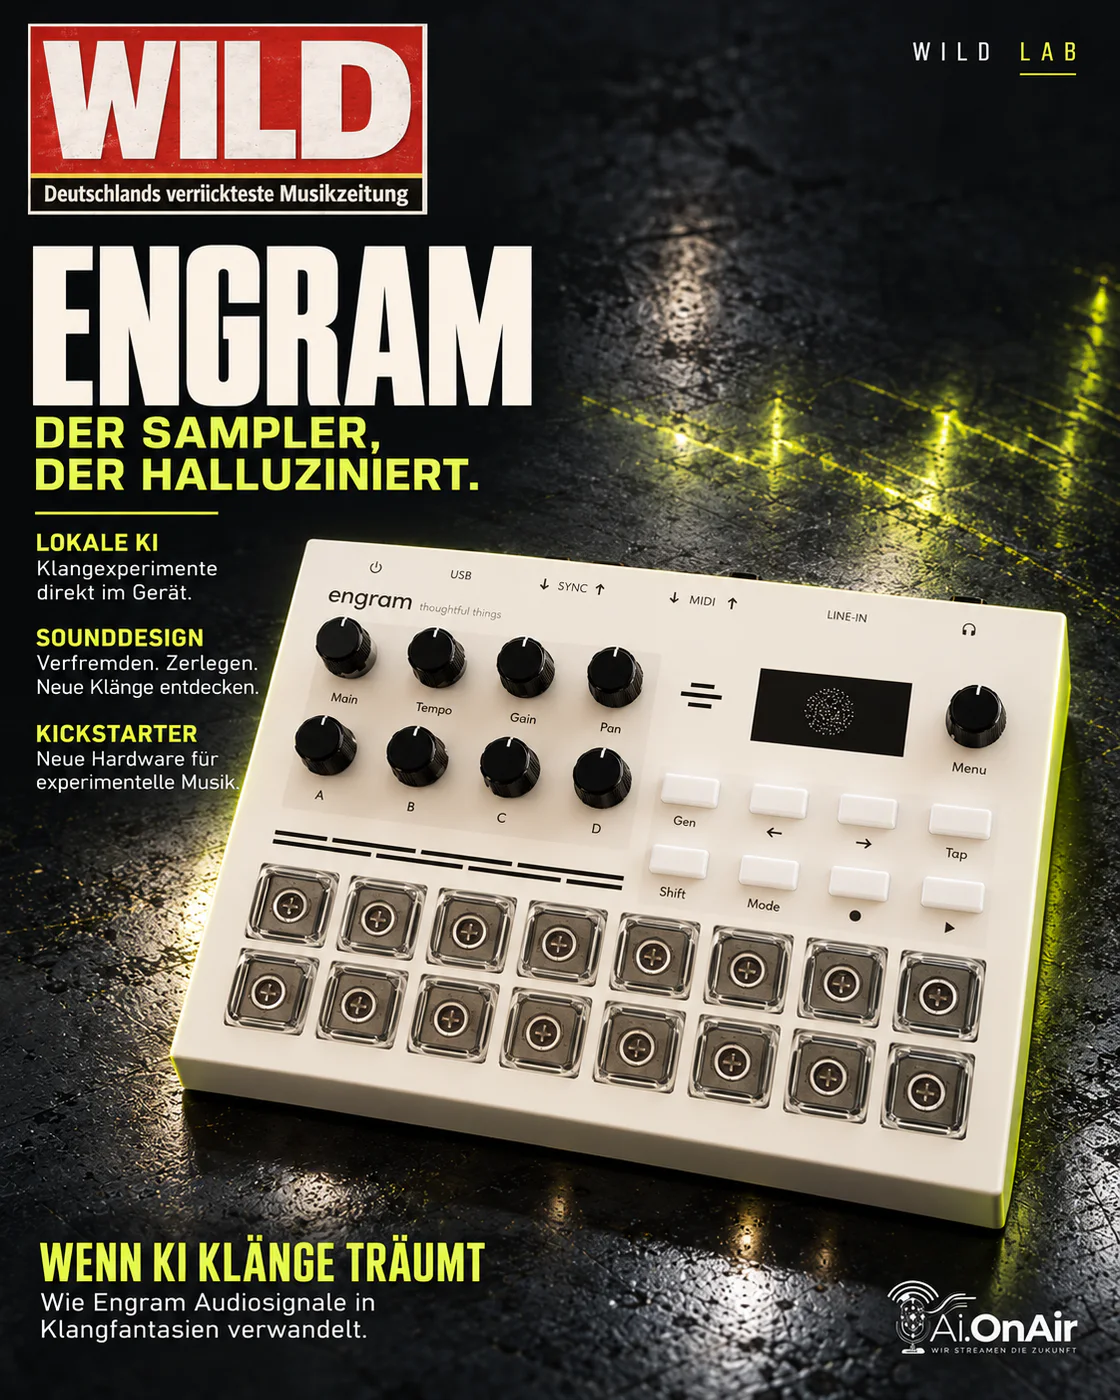
Engram heißt ein neuer Sampler, der mithilfe eines lokalen KI-Modells Audiosignale nicht nur verfremdet, sondern komplett halluzinierte Klänge erzeugt. Die Kickstarter-Kampagne ist am 27. September 2026 gestartet. Was steckt hinter dem Gerät, wie funktioniert die Technik, und für wen lohnt sich ein Blick darauf?
Spotify hat sich als ernstzunehmende Podcast-Plattform neben Apple Podcasts gestellt. Mit mehreren Hundert Millionen Nutzer*innen, wachsenden Video-Podcast-Funktionen und einem eigenen Partner-Programm lohnt sich der Blick auf die technischen Voraussetzungen, die Verteilung und die tatsächlichen Verdienstmöglichkeiten. Wir ordnen ein, was Stand September 2026 wirklich verfügbar ist.